지난 포스팅에 이어 두번째 프로젝트 포스팅이다. 지난번의 문제는, 첫발에 R스퀘어 값이 너무 높게 나왔다는 것이다. 물론 보기에는 기분좋지만 잘 들여다보면 유의수준 0.1에도 못미치는 계수가 많았다. 그래서 그 다음에 R스퀘어 값이 높이 나오는 이유에 대해서 알아보았다. 간략하게 그 이유에 대해서 정리해보면,
- R스퀘어 값 자체가 편향된 추정치이고 조정된 R스퀘어 값도 참고해야 한다.
- 관측치에 비해 너무 많은 변수를 넣어서 과적합된 모델이다.
- 변수끼리의 상관관계를 고려하지 않았다.
- 스케일링을 조정하지 않았다.
이 중에서, 가장 타당한 이유는 두번째 이유이다. 관측치에 비해 너무 많은 변수를 넣었다는 것이다. 관측치는 139개였는데 변수는 14개였다.(더미변수로 인해 변수의 숫자가 확장된 것이 원인이기도 하다)
일단 기본적인 전처리과정인 스케일링을 해보기로 했다.
1. 스케일링
스케일링에는 여러 방법이 있지만 이번 프로젝트에서 선택한 방법은 normalization(표준화)이다. Min-Max Scaling 이라고도 불리는 이 방법은 선택한 column의 값들을 0에서 1의 값으로 변환한다. 이번 프로젝트를 예로 들면, 전국영화 매출액은 적게는 몇 백만원, 많게는 수십억으로 굉장히 넓은 범위를 갖지만, 네티즌 평점과 같은 column은 0에서부터 많아봤자 10이 최대이다. 그러면 매출액이 큰 수가 많기 때문에 모델에 더 많은 영향을 미칠 수 있기 때문에 스케일링을 해야한다.
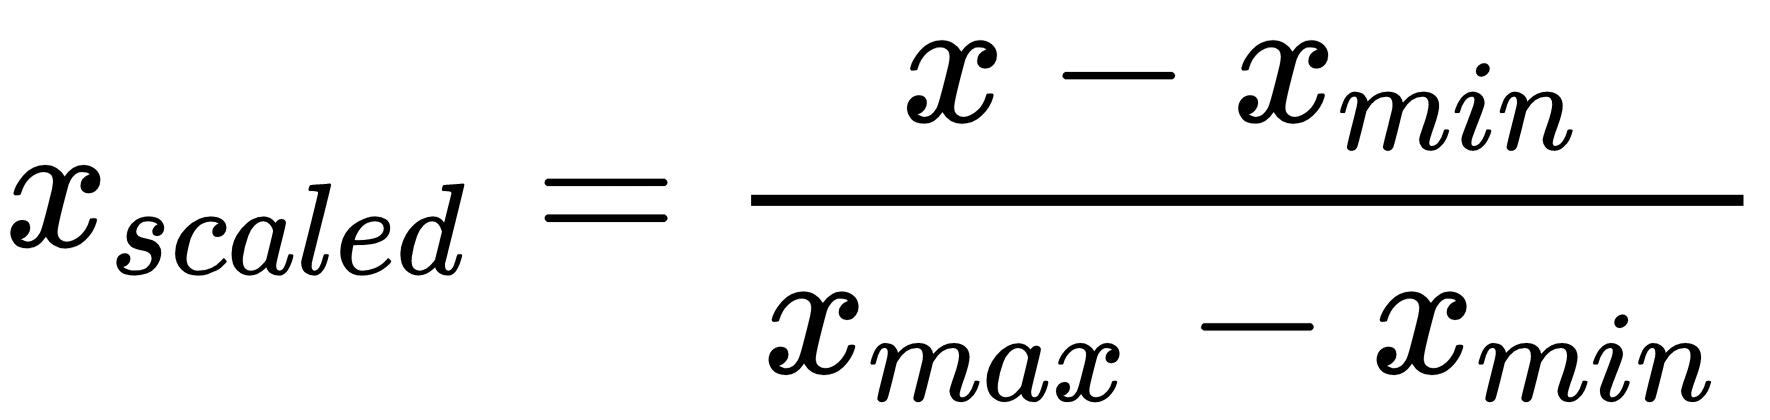
먼저 스케일링 함수를 만들고, 연속형변수에 해당하는 column에 이를 적용시켰다.
# Normalization scaling with new function
# make the range of the data between 0 and 1
normalize <- function(x) {
  return((x-min(x)) / (max(x)-min(x)))
}
movie_data$전국스크린수 <- normalize(movie_data$전국스크린수)
movie_data$전국매출액 <- normalize(movie_data$전국매출액)
movie_data$전국관객수 <- normalize(movie_data$전국관객수)
movie_data$상영횟수 <- normalize(movie_data$상영횟수)
movie_data$관람객평점 <- normalize(movie_data$관람객평점)
movie_data$평론가평점 <- normalize(movie_data$평론가평점)
movie_data$네티즌평점 <- normalize(movie_data$네티즌평점)
그리고 다시 계수추정(fit)을 시도 하였다.
> fit <- lm(전국매출액~., data=movie_data)
> summary(fit)

Call:
lm(formula = 전국매출액 ~ ., data = movie_data)

Residuals:
       Min         1Q     Median         3Q        Max
-0.0145376 -0.0007855  0.0002336  0.0007889  0.0129871

Coefficients: (1 not defined because of singularities)
               Estimate Std. Error t value Pr(>|t|)
(Intercept)  -7.786e-04  1.676e-03  -0.465   0.6430
메이저제작사 -8.138e-04  1.198e-03  -0.679   0.4982
메이저배급사  7.321e-05  1.060e-03   0.069   0.9450
전국스크린수 -6.302e-03  4.745e-03  -1.328   0.1866
전국관객수    1.005e+00  7.057e-03 142.374   <2e-16 ***
상영횟수      3.456e-03  5.159e-03   0.670   0.5042
독립여부      4.338e-04  9.555e-04   0.454   0.6506
스타파워      1.601e-03  1.093e-03   1.464   0.1457
감독파워     -1.817e-03  9.596e-04  -1.894   0.0606 .
관람객평점   -3.838e-04  1.997e-03  -0.192   0.8479
평론가평점    5.536e-04  1.632e-03   0.339   0.7350
네티즌평점   -2.888e-04  2.028e-03  -0.142   0.8870
청불          2.853e-03  1.633e-03   1.748   0.0830 .
X15세         1.160e-03  1.118e-03   1.037   0.3017
X12세         7.866e-05  1.086e-03   0.072   0.9424
전체                 NA         NA      NA       NA
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 0.003531 on 124 degrees of freedom
Multiple R-squared:  0.9994,	Adjusted R-squared:  0.9993
F-statistic: 1.411e+04 on 14 and 124 DF,  p-value: < 2.2e-16
하지만 안타깝게도 R스퀘어와 조정된 R스퀘어값에는 변화가 없었다. 여전히 '믿을 수 없을 정도로' 높은 값을 가졌다.
2. 연속형 변수만 선택하고 계수추정
> fit <- lm(전국매출액~ 전국관객수 + 전국스크린수 + 상영횟수 +
+                  관람객평점 + 평론가평점 + 네티즌평점, data=movie_data)
> summary(fit)

Call:
lm(formula = 전국매출액 ~ 전국관객수 + 전국스크린수 + 상영횟수 +
    관람객평점 + 평론가평점 + 네티즌평점, data = movie_data)

Residuals:
       Min         1Q     Median         3Q        Max
-0.0151513 -0.0004944  0.0000859  0.0006403  0.0120060

Coefficients:
               Estimate Std. Error t value Pr(>|t|)
(Intercept)   0.0006424  0.0013181   0.487   0.6268
전국관객수    1.0018665  0.0063161 158.621   <2e-16 ***
전국스크린수 -0.0076750  0.0029514  -2.600   0.0104 *
상영횟수      0.0054962  0.0048792   1.126   0.2620
관람객평점    0.0002741  0.0019340   0.142   0.8875
평론가평점    0.0009028  0.0015100   0.598   0.5509
네티즌평점   -0.0022159  0.0017223  -1.287   0.2005
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 0.003528 on 132 degrees of freedom
Multiple R-squared:  0.9993,	Adjusted R-squared:  0.9993
F-statistic: 3.299e+04 on 6 and 132 DF,  p-value: < 2.2e-16
더미변수가 영향을 미치는 것으로 추측하고 연속형 변수만을 선택하여 계수추정을 하였지만 결과는 달라지는 것이 없었다. 따라서 연속형 변수중에 지나치게 반응변수와 상관관계가 있는 항목이 있다고 판단하였고 이를 찾기 위해 scatter plot을 그려 보았다.
3. Scatter plot 확인
# check scatter plot with 매출액 and 관객수
plot(x=movie_data$전국매출액, y=movie_data$전국관객수)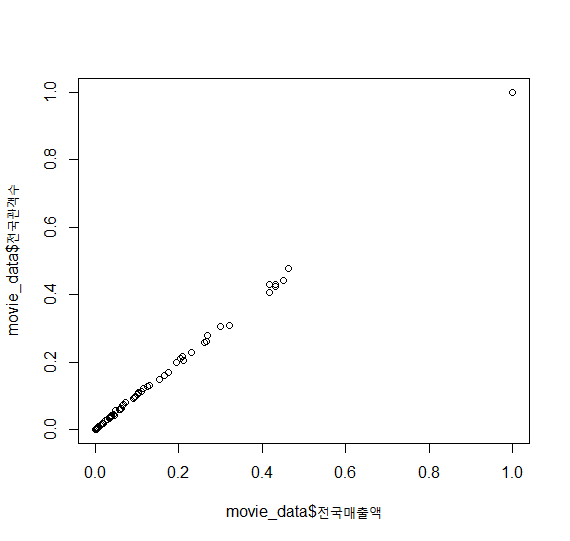
확인해 본 결과, 전국관객수는 전국매출액과 완벽한 양의 선형관계를 가졌다. 사실 이는 상식적으로 생각하기에도 당연한 관계이다. 관객이 많이 왔으니 매출액도 당연히 높겠지.. 그래서 전국관객수 변수를 뺀 연속형 변수끼리 계수추정을 시도했다.
4. 전국관객수를 제외한 연속형 변수끼리 계수추정
> # remove 전국관객수 variable and select continuous variables
> fit <- lm(전국매출액~ 전국스크린수 + 상영횟수 +
+                  관람객평점 + 평론가평점 + 네티즌평점, data=movie_data)
> summary(fit)

Call:
lm(formula = 전국매출액 ~ 전국스크린수 + 상영횟수 + 관람객평점 +
    평론가평점 + 네티즌평점, data = movie_data)

Residuals:
     Min       1Q   Median       3Q      Max
-0.11112 -0.00980  0.00559  0.01342  0.41151

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
(Intercept)  -0.042880   0.017779  -2.412   0.0172 *
전국스크린수 -0.005390   0.040700  -0.132   0.8948
상영횟수      0.601716   0.042901  14.026   <2e-16 ***
관람객평점    0.044812   0.026388   1.698   0.0918 .
평론가평점    0.007489   0.020816   0.360   0.7196
네티즌평점   -0.008699   0.023744  -0.366   0.7147
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 0.04865 on 133 degrees of freedom
Multiple R-squared:  0.8723,	Adjusted R-squared:  0.8675
F-statistic: 181.7 on 5 and 133 DF,  p-value: < 2.2e-16
!!!!
드디어, 뭔가 신뢰할만한 R스퀘어값과 조정된 R스퀘어 값이 나왔다. 87, 86 이 정도 수치는 주로 통계책에서 예시로 많이 나오는 수치이다! (이 수치에 대해 정확하게 해석하려면, 변수에 대한 설명이나, 더 많은 통계적 지식을 활용해야 하지만 일단은 기존의 지나치게 높게 나온 R스퀘어 값에 대한 의구점은 한 풀 접어도 될 것 같다)
이 결과에 힘 입어, 다분히 더미변수가 신뢰성이 없다고 판단하기는 힘들다고 생각했다. 따라서 전체 변수들에서 관객수만 빼고 다시 계수추정을 시도했다.
5. 전국관객수 변수를 제외한 모든 변수로 재적합
> # as I thought, 전국관객수 variable affect so much on the model
> # So, I select all variables except 전국관객수 variable
> #movie_data_nopeople <- movie_data[,-5]
> fit <- lm(전국매출액~.,data=movie_data_nopeople)
> summary(fit)

Call:
lm(formula = 전국매출액 ~ ., data = movie_data_nopeople)

Residuals:
     Min       1Q   Median       3Q      Max
-0.10154 -0.01463 -0.00166  0.01590  0.33462

Coefficients: (1 not defined because of singularities)
              Estimate Std. Error t value Pr(>|t|)
(Intercept)  -0.025394   0.021293  -1.193  0.23528
메이저제작사 -0.033630   0.015016  -2.240  0.02688 *
메이저배급사 -0.030306   0.013258  -2.286  0.02394 *
전국스크린수  0.192816   0.057918   3.329  0.00115 **
상영횟수      0.570119   0.041930  13.597  < 2e-16 ***
독립여부      0.012889   0.012153   1.061  0.29093
스타파워     -0.032985   0.013613  -2.423  0.01683 *
감독파워      0.005462   0.012240   0.446  0.65616
관람객평점    0.027125   0.025392   1.068  0.28746
평론가평점    0.015499   0.020800   0.745  0.45757
네티즌평점   -0.025924   0.025801  -1.005  0.31695
청불         -0.006162   0.020840  -0.296  0.76797
X15세        -0.013580   0.014222  -0.955  0.34149
X12세         0.004552   0.013864   0.328  0.74322
전체                NA         NA      NA       NA
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 0.0451 on 125 degrees of freedom
Multiple R-squared:  0.8968,	Adjusted R-squared:  0.8861
F-statistic: 83.59 on 13 and 125 DF,  p-value: < 2.2e-16
결과는 오히려 더 좋아졌다. 더미변수가 모델의 설명력을 소폭 높여준 것이다. 이제 지나치게 높아진 R스퀘어 문제를 해결 했으니(했다고 볼 수 있으니) 변수선택을 해서 설명력이 없는 변수를 걸러야 한다.
6. 변수선택
변수선택의 방법은 후진제거법을 선택했다. 후진제거법이란, AIC수치를 기준으로 한개씩 변수를 제거해가면서 AIC가 일정 값으로 작아질 때까지 제거를 반복하는 방법이다. 자세한 통계적 설명은 추후에 포스팅하겠다.(할 수 있다면ㅠ)
> # backward removal for variables selection
> step(fit, direction = 'backward')
Start:  AIC=-848.22
전국매출액 ~ 메이저제작사 + 메이저배급사 + 전국스크린수 + 상영횟수 +
    독립여부 + 스타파워 + 감독파워 + 관람객평점 + 평론가평점 +
    네티즌평점 + 청불 + X15세 + X12세 + 전체


Step:  AIC=-848.22
전국매출액 ~ 메이저제작사 + 메이저배급사 + 전국스크린수 + 상영횟수 +
    독립여부 + 스타파워 + 감독파워 + 관람객평점 + 평론가평점 +
    네티즌평점 + 청불 + X15세 + X12세

               Df Sum of Sq     RSS     AIC
- 청불          1   0.00018 0.25447 -850.12
- X12세         1   0.00022 0.25451 -850.10
- 감독파워      1   0.00041 0.25470 -850.00
- 평론가평점    1   0.00113 0.25542 -849.60
- X15세         1   0.00185 0.25615 -849.21
- 네티즌평점    1   0.00205 0.25635 -849.10
- 독립여부      1   0.00229 0.25658 -848.97
- 관람객평점    1   0.00232 0.25662 -848.96
<none>                      0.25430 -848.22
- 메이저제작사  1   0.01020 0.26450 -844.75
- 메이저배급사  1   0.01063 0.26493 -844.53
- 스타파워      1   0.01194 0.26624 -843.84
- 전국스크린수  1   0.02255 0.27684 -838.41
- 상영횟수      1   0.37611 0.63040 -724.03

Step:  AIC=-850.12
전국매출액 ~ 메이저제작사 + 메이저배급사 + 전국스크린수 + 상영횟수 +
    독립여부 + 스타파워 + 감독파워 + 관람객평점 + 평론가평점 +
    네티즌평점 + X15세 + X12세

               Df Sum of Sq     RSS     AIC
- 감독파워      1   0.00034 0.25482 -851.93
- X12세         1   0.00065 0.25513 -851.76
- 평론가평점    1   0.00109 0.25557 -851.53
- 네티즌평점    1   0.00189 0.25636 -851.10
- X15세         1   0.00193 0.25640 -851.07
- 관람객평점    1   0.00222 0.25669 -850.91
- 독립여부      1   0.00231 0.25678 -850.87
<none>                      0.25447 -850.12
- 메이저제작사  1   0.01028 0.26475 -846.62
- 메이저배급사  1   0.01064 0.26511 -846.43
- 스타파워      1   0.01225 0.26672 -845.59
- 전국스크린수  1   0.02282 0.27730 -840.18
- 상영횟수      1   0.37603 0.63050 -726.00

Step:  AIC=-851.93
전국매출액 ~ 메이저제작사 + 메이저배급사 + 전국스크린수 + 상영횟수 +
    독립여부 + 스타파워 + 관람객평점 + 평론가평점 + 네티즌평점 +
    X15세 + X12세

               Df Sum of Sq     RSS     AIC
- X12세         1   0.00056 0.25538 -853.63
- 평론가평점    1   0.00104 0.25586 -853.37
- 네티즌평점    1   0.00174 0.25655 -852.99
- X15세         1   0.00196 0.25677 -852.87
- 관람객평점    1   0.00208 0.25689 -852.81
- 독립여부      1   0.00279 0.25761 -852.42
<none>                      0.25482 -851.93
- 메이저배급사  1   0.01056 0.26537 -848.29
- 메이저제작사  1   0.01119 0.26600 -847.96
- 스타파워      1   0.01390 0.26871 -846.55
- 전국스크린수  1   0.02530 0.28011 -840.78
- 상영횟수      1   0.37743 0.63225 -727.62

Step:  AIC=-853.63
전국매출액 ~ 메이저제작사 + 메이저배급사 + 전국스크린수 + 상영횟수 +
    독립여부 + 스타파워 + 관람객평점 + 평론가평점 + 네티즌평점 +
    X15세

               Df Sum of Sq     RSS     AIC
- 평론가평점    1   0.00120 0.25658 -854.97
- 네티즌평점    1   0.00213 0.25751 -854.47
- 관람객평점    1   0.00230 0.25768 -854.38
- 독립여부      1   0.00325 0.25863 -853.87
<none>                      0.25538 -853.63
- X15세         1   0.00670 0.26208 -852.03
- 메이저배급사  1   0.01103 0.26641 -849.75
- 메이저제작사  1   0.01151 0.26689 -849.50
- 스타파워      1   0.01339 0.26877 -848.52
- 전국스크린수  1   0.02517 0.28055 -842.56
- 상영횟수      1   0.39415 0.64953 -725.87

Step:  AIC=-854.97
전국매출액 ~ 메이저제작사 + 메이저배급사 + 전국스크린수 + 상영횟수 +
    독립여부 + 스타파워 + 관람객평점 + 네티즌평점 + X15세

               Df Sum of Sq     RSS     AIC
- 네티즌평점    1   0.00125 0.25784 -856.30
- 관람객평점    1   0.00203 0.25861 -855.88
<none>                      0.25658 -854.97
- 독립여부      1   0.00480 0.26139 -854.39
- X15세         1   0.00581 0.26240 -853.86
- 메이저배급사  1   0.01003 0.26662 -851.64
- 메이저제작사  1   0.01158 0.26816 -850.84
- 스타파워      1   0.01333 0.26991 -849.94
- 전국스크린수  1   0.02598 0.28256 -843.57
- 상영횟수      1   0.39296 0.64955 -727.87

Step:  AIC=-856.3
전국매출액 ~ 메이저제작사 + 메이저배급사 + 전국스크린수 + 상영횟수 +
    독립여부 + 스타파워 + 관람객평점 + X15세

               Df Sum of Sq     RSS     AIC
- 관람객평점    1   0.00089 0.25872 -857.82
<none>                      0.25784 -856.30
- 독립여부      1   0.00454 0.26238 -855.87
- X15세         1   0.00477 0.26260 -855.75
- 메이저제작사  1   0.01113 0.26896 -852.42
- 메이저배급사  1   0.01142 0.26926 -852.27
- 스타파워      1   0.01283 0.27067 -851.55
- 전국스크린수  1   0.02596 0.28379 -844.96
- 상영횟수      1   0.39185 0.64969 -729.84

Step:  AIC=-857.82
전국매출액 ~ 메이저제작사 + 메이저배급사 + 전국스크린수 + 상영횟수 +
    독립여부 + 스타파워 + X15세

               Df Sum of Sq     RSS     AIC
<none>                      0.25872 -857.82
- X15세         1   0.00550 0.26423 -856.89
- 독립여부      1   0.00571 0.26443 -856.78
- 메이저배급사  1   0.01105 0.26977 -854.01
- 메이저제작사  1   0.01261 0.27134 -853.20
- 스타파워      1   0.01374 0.27247 -852.62
- 전국스크린수  1   0.02544 0.28416 -846.78
- 상영횟수      1   0.43041 0.68914 -723.64

Call:
lm(formula = 전국매출액 ~ 메이저제작사 + 메이저배급사 + 전국스크린수 +
    상영횟수 + 독립여부 + 스타파워 + X15세, data = movie_data_nopeople)

Coefficients:
 (Intercept)  메이저제작사  메이저배급사  전국스크린수      상영횟수
    -0.01437      -0.03619      -0.02976       0.19865       0.57477
    독립여부      스타파워         X15세
     0.01848      -0.02973      -0.01275
위에서 step함수의 결과를 살펴보면, 처음 모든 변수를 넣었을 시 start에서 AIC값은 -848.22였다. 변수를 제거해 가면서 최종 AIC값은 -857.82였다. 사실 step함수의 결과에서 눈여겨 볼 정보는 마지막에 최종으로 남은 변수들이다. 이 함수는 단순히 변수선택의 과정을 보여주는 것뿐이라서 결과가 위처럼 길게 나온다. 남은 변수들은 X15세(15세관람가), 독립여부(독립영화이면), 메이저배급사, 메이저제작사, 스타파워, 전국스크린수, 상영횟수였다. 이 변수들만을 가지고 다시 계수추정을 시도하였다.
7. 후진제거법으로 변수선택을 하고 재적합
> # fit again with selected variables
> fit <- lm(전국매출액 ~ X15세 + 독립여부 + 메이저배급사 + 메이저제작사 +
+                  스타파워 + 전국스크린수 + 상영횟수, data = movie_data_nopeople)
> summary(fit)

Call:
lm(formula = 전국매출액 ~ X15세 + 독립여부 + 메이저배급사 + 메이저제작사 +
    스타파워 + 전국스크린수 + 상영횟수, data = movie_data_nopeople)

Residuals:
     Min       1Q   Median       3Q      Max
-0.10445 -0.01204 -0.00147  0.01504  0.33663

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
(Intercept)  -0.014372   0.010898  -1.319 0.189559
X15세        -0.012746   0.007637  -1.669 0.097495 .
독립여부      0.018475   0.010866   1.700 0.091446 .
메이저배급사 -0.029759   0.012584  -2.365 0.019502 *
메이저제작사 -0.036191   0.014321  -2.527 0.012689 *
스타파워     -0.029728   0.011269  -2.638 0.009349 **
전국스크린수  0.198652   0.055350   3.589 0.000468 ***
상영횟수      0.574774   0.038935  14.763  < 2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 0.04444 on 131 degrees of freedom
Multiple R-squared:  0.895,	Adjusted R-squared:  0.8894
F-statistic: 159.6 on 7 and 131 DF,  p-value: < 2.2e-16
결과는 좋아졌다. 변수선택을 하기 전에는 계수들의 유의수준이 0.1에도 못미치는 게 많았으나 이번엔 X15세 변수와 독립여부 변수를 제외하고는 모두 유의수준이 0.05로 신뢰성이 대폭 향상되었다. 또한 R스퀘어 값은 소폭 낮아졌지만 조정된 R스퀘어 값은 오히려 소폭 높아졌다! 이는 설명력의 변동이 적어졌고 정확해졌다고 해석할 수 있다.
- 변수선택 전 : R-squared: 0.8968, Adjusted R-squared: 0.8861
- 변수선택 후 : R-squared: 0.895, Adjusted R-squared: 0.8894
물론 미세한 차이지만 성과가 있었다는 건 부정할 수 없다.
이번 포스팅은 여기서 마치겠다. 이번 포스팅을 요약해보자면,
1. 연속형 변수 스케일링
2. R스퀘어가 높아진 이유 탐색: 반응변수(전국매출액)과 지나치게 상관관계를 가진 변수(전국관객수) 삭제
3. 전국관객수 변수를 삭제하고 재적합
4. 변수선택(후진제거법) 후, 재적합
이 과정으로, 유의미한 변수들로 모델을 마련했다. 다음 포스팅에서는 이 모델의 설명력과 신뢰도에 대해서 알아볼 예정이다. 사실 이 부분이 지금 내가 가장 취약한 부분이라서 먼저 공부를 좀 하고 포스팅 할 예정이다. 아마 다음주쯤에는 꼭 올릴 것이다! (제발)
* 부족한 부분이 정말정말정말 많습니다. 누추한 이 포스팅을 읽고 불편한 점이 있거나 잘못된 점이 있으면 꼭꼭 말해주세요! 비난과 비판 환영입니다.
'R' 카테고리의 다른 글
| [R]회귀분석 - 영화관련 특성요인들과 매출액의 상관관계 분석 3 (0) | 2021.01.21 |
|---|---|
| [R]회귀분석 - 영화관련 특성요인들과 매출액의 상관관계 분석 1 (2) | 2020.12.29 |