블로그의 첫 게시글을 무엇으로 할 지 궁리하다가 먼저 작년에 학부에서 진행했던 프로젝트를 정리해서 올리는 것으로 시작하기로 했다. 작년에 했던거라 가물가물 하기도 하고 세부적인 부분에서 많이 부족한 점이 보였다. 그래서 같은 주제로 새로 시작하기로 결정했다. 진행하면서 R과 관련된 팁들도 새로운 게시물로 추가하고 살을 붙여나가는 식으로 블로그를 운영하는 편이 나을 것 같다.
1. 주제 소개
많은 영화가 제작되는 오늘날, 영화의 매출액이 어떤 요인들에 의해 변화하는지에 대해 다뤄보려고 한다. 2018년도에 개봉했던 영화들의 여러 특징들(제작사, 배급사, 감독, 배우, 연령등급 등)과 영화매출액에 어떤 상관관계가 있고 어느정도의 상관관계가 존재하는 지 분석하는 프로젝트이다.
2. 프로젝트 개요
- 사용할 데이터 : 2018년 한국영화 실질개봉작 (출처: 영화진흥위원회, 2019년도판 한국영화연감 5장 2018년 개봉일람)
(실질개봉작이란, 적어도 1개 상영관에서 일주일간 전일 상영되는 경우의 상영횟수인 약 40회 이상 상영된 작품(해당연도에 개봉하여 총 40회 이상 상영한 작품)을 말한다. 다만, 영화진흥위원회에 독립영화 또는 예술영화 인정신청을 한 후 심사를 거쳐 각각 해당 영화로 인정받은 독립/예술영화는 상영회차 40회 미만도 실질개봉작에 포함시킨다.)
- 프로젝트 예상기간 : 1주일
- 참고 논문 : 박승현, 송현주(2012). 영화의 흥행성과와 제작비규모와의 관계, 사회과학연구, 51(1), 45-79

3. 데이터 소개
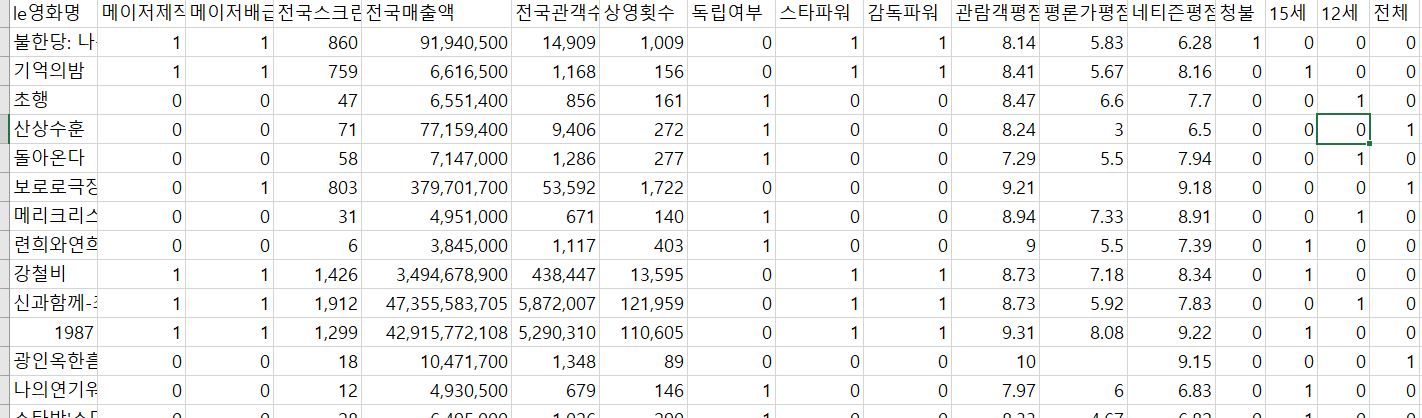
사실 상식적으로 영화의 제작비가 영화 매출액에 큰 영향을 미치지만 보안문제로 공개할 수 없는 데이터라고 영화진흥위원회에서 답변이 왔다. 따라서 위 기관에서 제공하는 데이터 뿐만 아니라 포털사이트에서 검색할 수 있는 네티즌, 관객, 평론가 평점을 추가하였다. 또한 제작사와 배급사가 매우 다양하여, 제작사와 배급사가 어느정도 규모가 있는 회사이면 메이저제작사 메이저배급사로 표시하였다. 감독과 배우또한 인지도를 고려하여, 스타감독이나 스타배우가 참여한 작품인지에 대해 1,0으로 더미변수 처리하였다. 연령등급 또한 범주형 변수라서 더미변수 처리하였다.
..
라고 썼지만 굉장한 노가다였다. 한국영화연감의 데이터는 pdf파일이라서 엑셀로 변환하고 오류사항을 일일히 바꿔야 했다. 평점이나 메이저제작사 및 배급사, 스타감독 및 배우 같은 데이터도 조원들의 역할 분담이 없었더라면 하루는 꼬박 걸렸을 것이다. 만약 작년 조원들이 우연히 이 글을 본다면 다시한번 깊은 감사의 표시를 하고싶다.
반응변수: 전국매출액 (연속형 변수)
설명변수
- 메이저제작사 (더미변수 1,0으로 구분.)
- 메이저배급사 (더미변수 1,0으로 구분.)
- 전국스크린수 (연속형 변수)
- 전국관객수 (연속형 변수)
- 상영횟수 (연속형 변수)
- 독립여부 (더미변수 1,0으로 구분.)
- 스타파워 (더미변수 1,0으로 구분.)
- 감독파워 (더미변수 1,0으로 구분.)
- 관람객평점 (연속형 변수)
- 평론가평점 (연속형 변수)
- 네티즌평점 (연속형 변수)
- 연령등급_ 청불 (더미변수 1,0으로 구분.)
- 연령등급_ 15세 (더미변수 1,0으로 구분.)
- 연령등급_ 12세 (더미변수 1,0으로 구분.)
- 연령등급_ 전체 (더미변수 1,0으로 구분.)
4. 분석시작
- 사용 언어: R
1) 데이터 요약
# work directory 설정
> setwd("C:/Users/ok/iCloudDrive/KMU/blog/201223 linear regression")

 # 불러올 csv파일 선택후 변수로 저장
> movie <- read.csv("movie_new2.csv")

#데이터셋의 기본적인 형태 확인
> head(movie)
                   le영화명 메이저제작사 메이저배급사 전국스크린수 전국매출액 전국관객수 상영횟수 독립여부 스타파워
1  불한당: 나쁜 놈들의 세상            1            1          860   91940500      14909     1009        0        1
2                  기억의밤            1            1          759    6616500       1168      156        0        1
3                      초행            0            0           47    6551400        856      161        1        0
4                  산상수훈            0            0           71   77159400       9406      272        1        0
5                  돌아온다            0            0           58    7147000       1286      277        1        0
6 보로로극장판 공룡섬대모험            0            1          803  379701700      53592     1722        0        0
  감독파워 관람객평점 평론가평점 네티즌평점 청불 X15세 X12세 전체
1        1          8          6          6    1     0     0    0
2        1          8          6          8    0     1     0    0
3        0          8          7          8    0     0     1    0
4        0          8          3          7    0     0     0    1
5        0          7          6          8    0     0     1    0
6        0          9         NA          9    0     0     0    1
대충 데이터셋은 이런 모양인 것을 확인했다.
#remove the first column(movie titles)
#영화 제목은 분석과정에서는 필요없기 때문에 삭제
movie_data <- movie[,-1]

#remove the column including N/A
#결측치가 있는 row들을 제거
movie_data <- na.omit(movie_data)

#In the original dataset, switch the data format for analyzing
#remove the comma in the numeric data
#데이터를 분석가능한 형태로 바꾸는 작업
movie_data$전국스크린수 <- as.numeric(movie_data$전국스크린수)
movie_data$전국매출액 <- as.numeric(movie_data$전국매출액)
movie_data$전국관객수 <- as.numeric( movie_data$전국관객수)
movie_data$상영횟수 <- as.numeric(movie_data$상영횟수)
movie_data$관람객평점 <- as.numeric(movie_data$관람객평점)
movie_data$X15세 <- as.factor(movie_data$X15세)
movie_data$X12세 <- as.factor(movie_data$X12세)
movie_data$메이저제작사 <- as.factor(movie_data$메이저제작사)
movie_data$메이저배급사 <- as.factor(movie_data$메이저배급사)
movie_data$독립여부 <- as.factor(movie_data$독립여부)
movie_data$스타파워 <- as.factor(movie_data$스타파워)
movie_data$감독파워 <- as.factor(movie_data$감독파워)
movie_data$청불 <- as.factor(movie_data$청불)
movie_data$전체 <- as.factor(movie_data$전체)

#check the type of features
str(movie_data)
'data.frame':	139 obs. of  16 variables:
 $ 메이저제작사: Factor w/ 2 levels "0","1": 2 2 1 1 1 1 1 2 2 2 ...
 $ 메이저배급사: Factor w/ 2 levels "0","1": 2 2 1 1 1 1 1 2 2 2 ...
 $ 전국스크린수: num  860 759 47 71 58 ...
 $ 전국매출액  : num  91940500 6616500 6551400 77159400 7147000 ...
 $ 전국관객수  : num  14909 1168 856 9406 1286 ...
 $ 상영횟수    : num  1009 156 161 272 277 ...
 $ 독립여부    : Factor w/ 2 levels "0","1": 1 1 2 2 2 2 2 1 1 1 ...
 $ 스타파워    : Factor w/ 2 levels "0","1": 2 2 1 1 1 1 1 2 2 2 ...
 $ 감독파워    : Factor w/ 2 levels "0","1": 2 2 1 1 1 1 1 2 2 2 ...
 $ 관람객평점  : num  8 8 8 8 7 9 9 9 9 9 ...
 $ 평론가평점  : num  6 6 7 3 6 7 6 7 6 8 ...
 $ 네티즌평점  : num  6 8 8 7 8 9 7 8 8 9 ...
 $ 청불        : Factor w/ 2 levels "0","1": 2 1 1 1 1 1 1 1 1 1 ...
 $ X15세       : Factor w/ 2 levels "0","1": 1 2 1 1 1 1 2 2 1 2 ...
 $ X12세       : Factor w/ 2 levels "0","1": 1 1 2 1 2 2 1 1 2 1 ...
 $ 전체        : Factor w/ 2 levels "0","1": 1 1 1 2 1 1 1 1 1 1 ...
 - attr(*, "na.action")= 'omit' Named int [1:70] 6 12 18 24 31 32 33 35 37 38 ...
  ..- attr(*, "names")= chr [1:70] "6" "12" "18" "24" ...

#summary of the data
summary(movie_data)
 메이저제작사 메이저배급사  전국스크린수      전국매출액          전국관객수          상영횟수      독립여부 스타파워
 0:90         0:77         Min.   :   1.0   Min.   :2.235e+05   Min.   :      35   Min.   :     6   0:81     0:81
 1:49         1:62         1st Qu.:  36.0   1st Qu.:1.853e+07   1st Qu.:    2356   1st Qu.:   407   1:58     1:58
                           Median : 181.0   Median :1.543e+08   Median :   19843   Median :  1947
                           Mean   : 454.4   Mean   :6.504e+09   Mean   :  783974   Mean   : 23292
                           3rd Qu.: 873.0   3rd Qu.:6.397e+09   3rd Qu.:  769792   3rd Qu.: 31307
                           Max.   :2235.0   Max.   :1.027e+11   Max.   :12274996   Max.   :179979
 감독파워   관람객평점       평론가평점      네티즌평점     청불    X15세  X12세  전체
 0:100    Min.   : 5.000   Min.   :2.000   Min.   : 4.000   0:130   0:71   0:96   0:120
 1: 39    1st Qu.: 8.000   1st Qu.:5.000   1st Qu.: 6.000   1:  9   1:68   1:43   1: 19
          Median : 8.000   Median :6.000   Median : 7.000
          Mean   : 8.288   Mean   :5.647   Mean   : 7.137
          3rd Qu.: 9.000   3rd Qu.:6.500   3rd Qu.: 8.000
          Max.   :10.000   Max.   :8.000   Max.   :10.000
각 column들을 분석가능한 형태로 바꾸고 요약통계를 확인하였다.
연속형 변수열의 히스토그램과 데이터셋의 산점도 행렬을 확인
#descriptive statistic
hist(movie_data$전국매출액)
hist(movie_data$전국스크린수)
hist(movie_data$전국관객수)
hist(movie_data$상영횟수)
hist(movie_data$관람객평점)
hist(movie_data$평론가평점)
hist(movie_data$네티즌평점)

#scatter plot matrix
pairs(movie_data)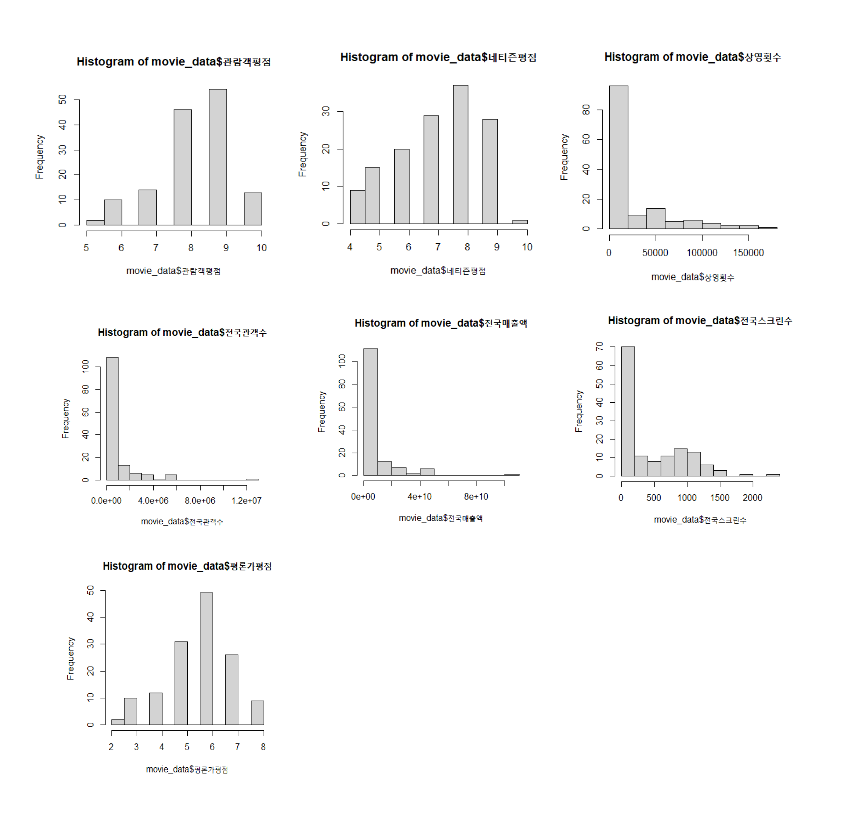
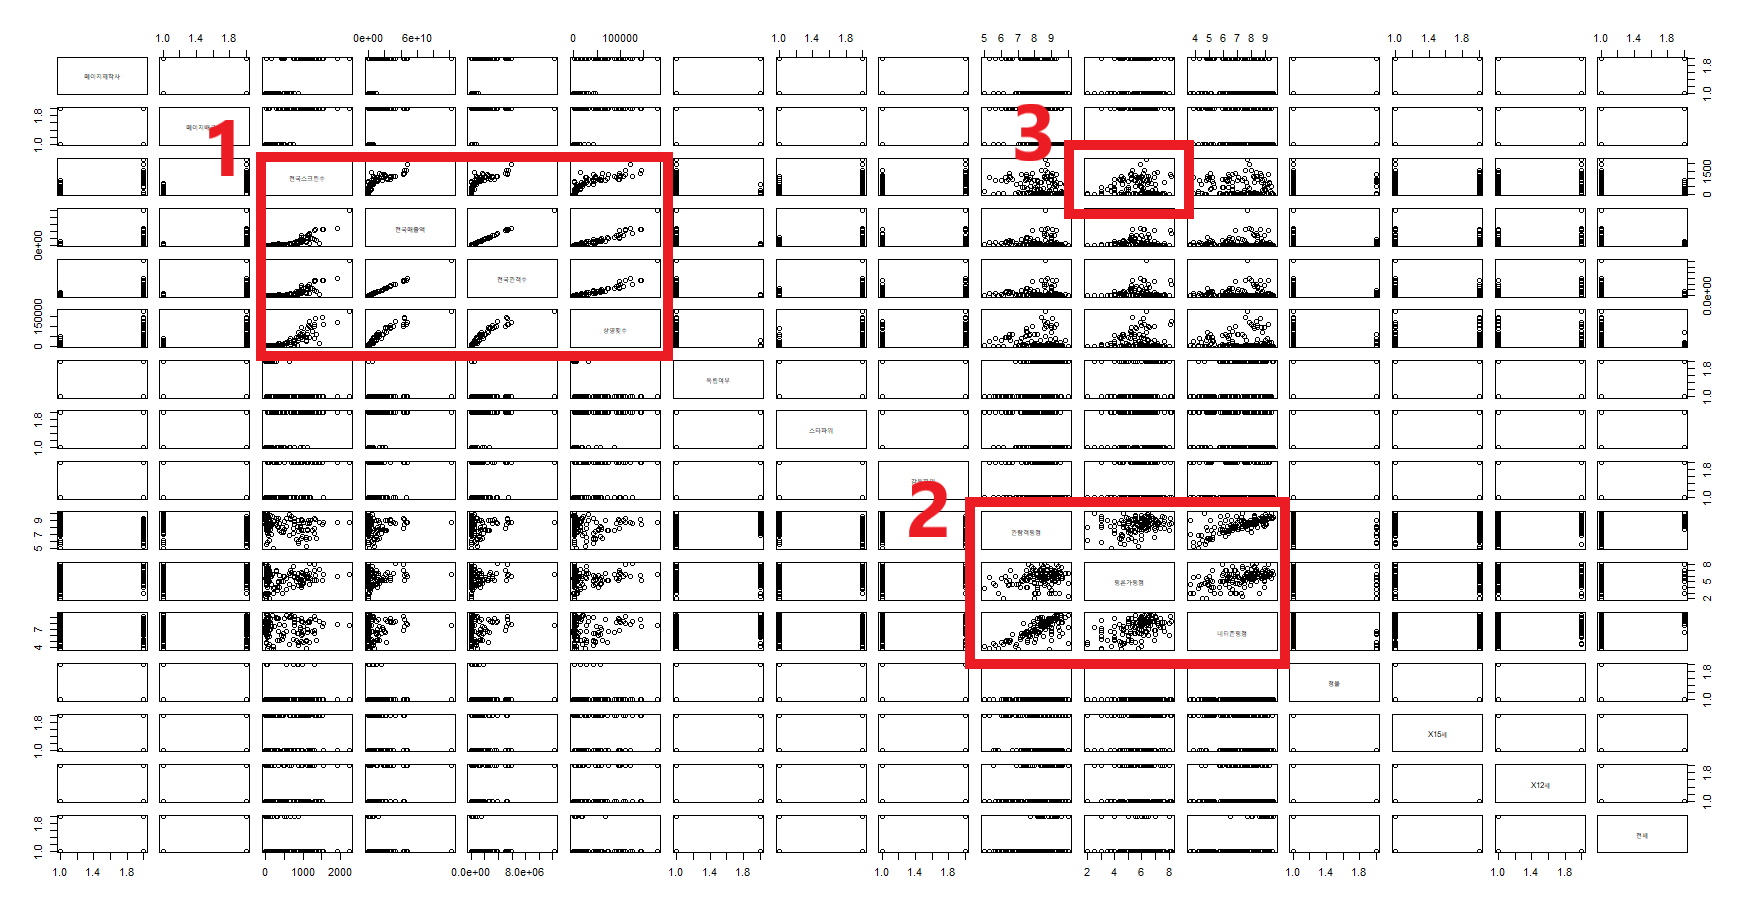
위 그림의 번호에 해당하는 정보는,
1 상영횟수, 전국매출액, 전국관람객수, 전국스크린수 이 네가지의 column끼리의 조합의 산점도는 모두 양의 상관관계를 보였고,
2 평론가평점,네티즌평점,관람객평점 이 세가지의 column끼리의 조합의 산점도 역시 양의 상관관계를 보였다.
3 눈여겨볼 곳은, 평론가평점과 전국스크린수가 약하지만 양의 상관관계를 보였다는 점이다.
2) 계수추정
- 회귀모형: Yi= β0+β1Xi1++β2Xi2+···+β14Xi14+β15Xi15+ϵi, i=1,2, ···,139
# 선형모델(lm)으로 계수추정
> fit <- lm(전국매출액~., data=movie_data)

# 모델 요약
> summary(fit)

Call:
lm(formula = 전국매출액 ~ ., data = movie_data)

Residuals:
       Min         1Q     Median         3Q        Max
-1.493e+09 -8.064e+07  2.398e+07  8.099e+07  1.333e+09

Coefficients: (1 not defined because of singularities)
                Estimate Std. Error t value Pr(>|t|)
(Intercept)   -3.951e+07  3.117e+08  -0.127   0.8993
메이저제작사1 -8.355e+07  1.230e+08  -0.679   0.4982
메이저배급사1  7.516e+06  1.088e+08   0.069   0.9450
전국스크린수  -2.896e+05  2.181e+05  -1.328   0.1866
전국관객수     8.403e+03  5.902e+01 142.374   <2e-16 ***
상영횟수       1.971e+03  2.943e+03   0.670   0.5042
독립여부1      4.454e+07  9.810e+07   0.454   0.6506
스타파워1      1.643e+08  1.122e+08   1.464   0.1457
감독파워1     -1.866e+08  9.852e+07  -1.894   0.0606 .
관람객평점    -7.881e+06  4.101e+07  -0.192   0.8479
평론가평점     9.473e+06  2.792e+07   0.339   0.7350
네티즌평점    -4.941e+06  3.470e+07  -0.142   0.8870
청불1          2.929e+08  1.676e+08   1.748   0.0830 .
X15세1         1.191e+08  1.148e+08   1.037   0.3017
X12세1         8.076e+06  1.115e+08   0.072   0.9424
전체1                 NA         NA      NA       NA
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 362500000 on 124 degrees of freedom
Multiple R-squared:  0.9994,	Adjusted R-squared:  0.9993
F-statistic: 1.411e+04 on 14 and 124 DF,  p-value: < 2.2e-16
Residuals: 잔차의 최소값, 1분위수, 중위수, 3분위수, 최대값을 나타낸다.
Intercept: 상수항
Estimate: 계수추정치
Std. Error: 표준오차
t value: t값
Pr: p값
signif. codes: 별(*)이 세 개이면 유의수준 0에서 만족 ... 점(.)은 유의수준 0.1에서 만족. 아무것도 없으면 유의하지 않음
Residual standard error: 잔차표준오차
Multiple R-squared: R스퀘어 값 (회귀식의 설명력을 나타냄)
Adjusted R-squared: 조정된 R스퀘어 값 (R스퀘어 값 보다 더 정확한 설명력을 나타냄)
F-statistic: F통계량
이론상으로 R스퀘어 값이나 adjusted R 스퀘어값이 0.60이 넘으면 유의미한 회귀식이고 1은 완전한 회귀식이다. 하지만 아이러니하게도 별다른 조정을 해주지 않은 상태에서 R스퀘어 값이 0.99가 나왔고 조정된 R스퀘어 값도 0.99가 나왔다. 이는 회귀식이 잘 설명했다고 볼 수는 없다. 사실 정확한 이유는 단언 할 수 없지만 추측하자면 복잡도가 늘어났다고 생각할 수 밖에 없겠다. 즉, 모든 관측치를 다 설명하려는 회귀식이 되어버렸다.
이번 포스팅은 여기서 마치고 다음 포스팅에서는,
1. 연속형 변수들의 관측치가 0과 1사이의 값이 나오도록 스케일을 조정하고,
2. 스케일을 조정해도 별다른 차이가 없다면 더미변수를 모두 제거하고 연속형 변수끼리만 회귀식을 만들어 볼 계획이다. 이러한 시도를 했을때, R스퀘어값이 이번처럼 지나치게 높게나오면 회귀모델이 아니라 로지스틱회귀모델을 사용할 계획이고, 지나치게 낮게 나오면, 변수선택의 과정을 거쳐 조금이라도 R스퀘어값을 높여볼 계획이다.
3. 변수선택의 과정을 진행한다면, 아노바테이블확인, 편제곱합 확인(부분F검정), 잔차분석을 통해 선형회귀분석의 설명력을 더 깊게 확인할 예정이다.
..
마치며.
이번 포스팅을 하면서 내가 아직 한참 부족하다는 것을 느꼈다. 사실은 작년에 계수추정을 할 때는, 위와같은 말도 안되는 R스퀘어값이 나오지 않았다. 처음엔 0.1~0.2에서 시작하여 서서히 올려가는 과정이 있었는데 이번에는 이렇게 나오니 심히 당혹스러웠다. 그래서 포기할까 했지만 그냥 망친 프로젝트라도 올려보기로 했다. 누군가 이 포스팅을 본다면 제발 신랄하게 까줬으면 한다. (사실 뭐가 잘못되었는지 짚어주면 정말 감사하겠습니다.) 한 포스팅에 끝까지 끝내려 했지만 이는 말도안되는 욕심이었다. 이 프로젝트로 몇개의 포스팅으로 질질끌지는 모르겠지만 내가 낼 수 있는 최대한의 결론은 내고 끝내야 겠다. 유의미한 결과는 아닐지라도 내가 스스로 공부하는 계기가 되었으면 하는 바램이다.
'R' 카테고리의 다른 글
| [R]회귀분석 - 영화관련 특성요인들과 매출액의 상관관계 분석 3 (0) | 2021.01.21 |
|---|---|
| [R]회귀분석 - 영화관련 특성요인들과 매출액의 상관관계 분석 2 (0) | 2021.01.02 |